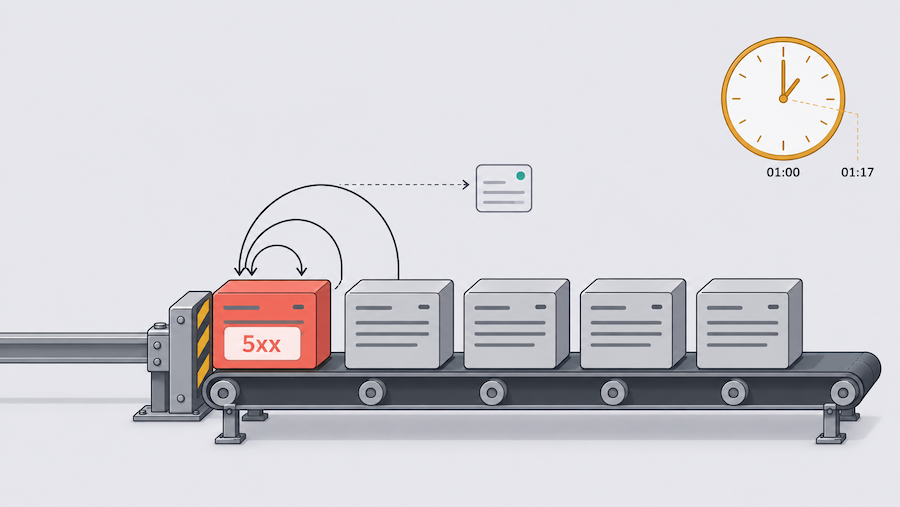

Chegou um e-mail de um parceiro que consome nossas APIs de delivery. A sincronização noturna de cardápios dele falhou em cinco das últimas dez noites. Sempre no mesmo ponto, sempre no mesmo horário, sempre do mesmo jeito: a primeira chamada do job devolveu HTTP 5xx, e o lote inteiro parou em quinze segundos.
Nas noites em que dava certo, o mesmo job levava de dois a quatro minutos. Nas noites em que dava errado, nenhum cardápio era atualizado, e ninguém percebia até alguém abrir o app e ver preço velho. O que me incomodou não foi o 5xx. Foi o lote inteiro depender de um único request dar certo na primeira tentativa.
Toda integração em lote começa igual
Você precisa sincronizar um conjunto de recursos e não sabe quais são. A primeira chamada é sempre a mesma: um endpoint que lista tudo, com detalhamento completo, para economizar viagens depois.
É conveniente, e também é quase sempre a chamada mais cara da API inteira: ela agrega relacionamento e monta um payload grande para um cliente que só queria uma lista de identificadores.
Some a isso o horário. Cron em hora cheia é o padrão do universo: você, o outro parceiro, o relatório interno e a rotina de limpeza chegando no mesmo segundo, no mesmo banco.
Quatro erros somados, e nenhum deles é o 5xx
O erro reportado foi o 5xx, mas ele é só o gatilho. O que transforma uma resposta ruim em uma noite inteira perdida é o desenho do job:
- A primeira chamada é ponto único de falha. Se ela cai, nada acontece. Sem plano B, sem sincronização parcial, sem nem sequer uma tentativa a mais.
- O agendamento concentra carga. Hora cheia é um pico artificial que você mesmo cria.
- 5xx não vira exceção sozinho. O cliente HTTP do Laravel, ao contrário do Guzzle puro, não lança exceção em respostas 4xx e 5xx. Ele devolve a resposta e espera que você pergunte.
- O resultado é binário. Ou sincroniza tudo, ou não sincroniza nada.
Esse último ponto é o que costuma passar despercebido em revisão de código. Olhe o job ingênuo:
use Illuminate\Contracts\Queue\ShouldQueue;
use Illuminate\Support\Facades\Http;

class SyncPartnerMenus implements ShouldQueue
{
    public function __construct(
        private string $baseUrl,
        private string $groupId,
    ) {}

    public function handle(): void
    {
        $group = Http::get("{$this->baseUrl}/grupo-economico", [
            'codigo_grupo' => $this->groupId,
            'detailed' => true,
        ])->json();

        foreach ($group['restaurantes'] ?? [] as $restaurant) {
            $this->syncMenu($restaurant);
        }
    }

    private function syncMenu(array $restaurant): void
    {
        // grava o cardápio do restaurante
    }
}Repare no que acontece quando esse endpoint devolve 500. O json() devolve o corpo do erro, que não tem a chave restaurantes. O ?? [] vira array vazio, o foreach não roda nenhuma vez, e o job termina sem lançar exceção.
O pior caso, portanto, não é o job que quebra. É o job que fica verde no painel, não sincroniza nada e não avisa ninguém. Já escrevi sobre o outro lado dessa mesma moeda em validação defensiva de payload em integração externa, quando o parceiro devolve 200 com o conteúdo errado.
Como consertar o desenho, em quatro passos
Passo 1: faça o 5xx doer, e tente de novo antes de desistir
A primeira correção é parar de tratar resposta de erro como resposta válida, e dar ao request uma chance real de se recuperar de uma falha passageira.
use Illuminate\Support\Facades\Http;

$response = Http::connectTimeout(5)
    ->timeout(15)
    ->retry(4, function (int $attempt) {
        // 2s, 4s, 6s, 8s, com um empurrãozinho aleatório
        return ($attempt * 2000) + random_int(0, 1000);
    }, throw: false)
    ->get("{$this->baseUrl}/grupo-economico", [
        'codigo_grupo' => $this->groupId,
        'detailed' => true,
    ]);

if ($response->serverError()) {
    throw new PartnerGroupUnavailable(
        "Lista de grupo indisponível: HTTP {$response->status()}"
    );
}Três decisões nesse bloco. O retry() aceita uma closure como segundo argumento para calcular o intervalo entre tentativas, e é ali que entra o backoff. O throw: false faz o cliente devolver a última resposta em vez de lançar RequestException, então a decisão continua sua. E o serverError() detecta o 5xx, porque ninguém detecta por você.
O random_int() não é firula: se cinquenta consumidores tentam de novo exatamente dois segundos depois, você só reagendou a mesma avalanche. O timeout também importa, já que o padrão é 30 segundos para a resposta e 10 para a conexão.
Passo 2: deixe o job falhar de verdade, e voltar mais tarde
Retry de HTTP resolve soluço de segundos. Não resolve indisponibilidade de minutos. Para isso existe a tentativa no nível do job.
use Illuminate\Contracts\Queue\ShouldQueue;
use Illuminate\Foundation\Queue\Queueable;
use Throwable;

class FetchPartnerGroup implements ShouldQueue
{
    use Queueable;

    public int $tries = 5;

    /**
     * Segundos de espera antes de cada nova tentativa.
     *
     * @return array<int, int>
     */
    public function backoff(): array
    {
        return [60, 300, 900, 1800];
    }

    public function handle(): void
    {
        // a chamada do passo 1 vive aqui
    }

    public function failed(Throwable $exception): void
    {
        // aqui é onde alguém finalmente fica sabendo
    }
}A diferença entre os dois níveis é a escala de tempo. O retry() do cliente HTTP trabalha em segundos, dentro do mesmo request. O $tries com backoff() trabalha em minutos, devolvendo o job para a fila.
Uma janela noturna aguenta tentar de novo daqui a meia hora. Um request de usuário, não. E o failed() é onde a falha definitiva deixa de ser número no gráfico e vira notificação para alguém.
Passo 3: pare de tratar a sincronização como tudo ou nada
Este passo muda a natureza do problema: em vez de um job grande que faz quarenta sincronizações em sequência, despache um lote com quarenta jobs pequenos.
use Illuminate\Bus\Batch;
use Illuminate\Support\Facades\Bus;
use Illuminate\Support\Facades\Log;

Bus::batch(
    collect($restaurants)
        ->map(fn (array $item) => new SyncRestaurantMenu($item['id']))
        ->all()
)
    ->allowFailures()
    ->finally(function (Batch $batch) {
        Log::info('Lote de cardápios encerrado', [
            'total' => $batch->totalJobs,
            'processados' => $batch->processedJobs(),
            'falhas' => $batch->failedJobs(),
        ]);
    })
->dispatch();O allowFailures() é o detalhe que importa. Por padrão, se um job do lote falha, o lote inteiro é cancelado, e é exatamente isso que você não quer aqui: um cardápio com problema não pode congelar os outros trinta e nove.
Com o lote, “a sincronização falhou” vira “trinta e oito atualizaram, dois falharam, e eu sei quais”. O progress() devolve o percentual e o finally() roda no fim, independentemente do resultado.
Duas exigências: os jobs precisam da trait Illuminate\Bus\Batchable, e a base precisa da tabela de lotes, que costuma vir na migration padrão 0001_01_01_000003_create_jobs_batches_table.php. Se ela não existir, php artisan make:queue-batches-table cria.
Passo 4: saia da hora cheia
O passo mais barato de todos. Nenhum contrato de integração exige que a sua rotina rode exatamente em 01:00:00.
use Illuminate\Support\Facades\Schedule;

Schedule::job(new SyncPartnerMenus($groupId))
    ->name("sync-menus:{$groupId}")
    ->dailyAt('01:17')
    ->timezone('UTC')
    ->withoutOverlapping(30)
->onOneServer();O 01:17 não tem nada de especial, ele só não é onde todo mundo está. O withoutOverlapping(30) evita que uma noite lenta empilhe com a execução seguinte, com lock expirando em trinta minutos em vez das vinte e quatro horas padrão.
O onOneServer() exige cache compartilhado em database, memcached, dynamodb ou redis, e evita que três servidores rodem a mesma rotina três vezes. O name() ali não é decoração: quando o mesmo job é agendado com parâmetros diferentes, é ele que dá a cada permutação um lock próprio.
Quem já passou por uma migração forçada de API de parceiro, como em o parceiro matou a API legada e te deu 30 dias, sabe que rotina duplicada em madrugada só aparece na fatura.
Boas práticas que fecham o buraco
- Escreva com
upsert, nunca com “apaga e insere”. Sincronização parcial não pode deixar o cliente sem cardápio nenhum. - Não descarte o último snapshot bom antes de ter o novo. Dado velho é ruim, tela vazia é pior.
- Alerte por ausência, não só por erro. “Nenhuma sincronização completa nas últimas 26 horas” teria pego esse caso.
- Registre a duração de cada execução e avise o outro lado com dados. Quinze segundos contra três minutos é um sinal gritante, e horários, URL e resultado de cada noite transformam “sua API está instável” em algo investigável.
Limitações honestas
Retry não conserta provedor quebrado. Se o 500 for determinístico, por bug de dado ou consulta que estoura o tempo do banco, tentar de novo adia a falha e ainda castiga quem está do outro lado.
Retry sem aleatoriedade piora o problema, e é por isso que o jitter está no passo 1. Lote também tem custo, porque guarda estado em banco e exige política de limpeza desses registros.
Mais importante: nada disso descobre a causa raiz. No caso que abriu este artigo, ela ainda está em aberto do nosso lado. O que os quatro passos garantem é que a próxima falha isolada custe um retry, e não uma noite inteira de dado congelado.